هر جمله صیقلخوردهای مدرک جرم نیست!
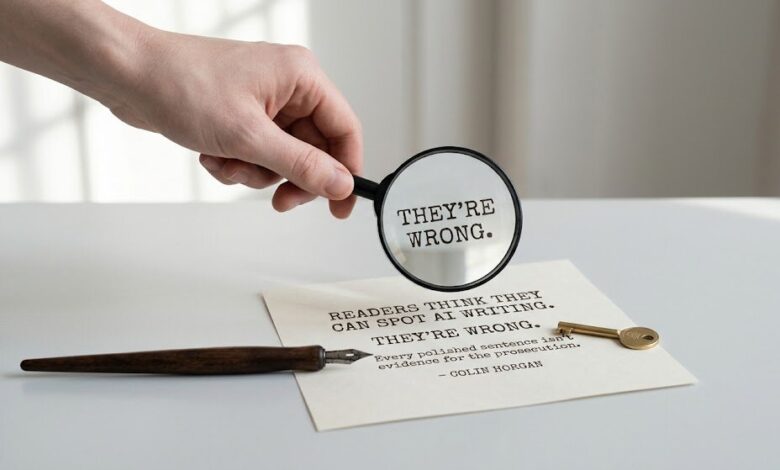
کالین هورگان نویسنده، متخصص ارتباطات ساکن تورنتو و متننویس سابق جاستین ترودو در یادداشتی که در سایت والروس منتشر کرده درباره خصوصیات نوشتههای هوش مصنوعی توضیح میدهد.
به گزارش اطلاعات آنلاین، در این یادداشت آمده است: «یک پرسش از شما دارم: آیا میدانید یک نوشته ساختهشده با هوش مصنوعی چه شکلی است؟ نه، این از آن پاراگرافهایی نیست که وقتی به پایانش میرسید بفهمید تمام این مدت توسط هوش مصنوعی نوشته شده بود. این یک پرسش کاملا جدی است؛ پرسشی که اطمینان دارم خودتان هم از خودتان پرسیدهاید و من هم از خودم پرسیدهام. پرسشی که من پاسخی برای آن ندارم و شک دارم شما هم پاسخی داشته باشید، اما روزبهروز بیشتر از ما انتظار میرود به آن پاسخ دهیم. پرسشی که همه ما را به خوانندگانی از جنسی دیگر تبدیل میکند — بدبین، پرخاشگر و بیمیل به اینکه به همنوعان خود حق حسننیت بدهیم. تلاش برای فهمیدن اینکه نوشته هوش مصنوعی چه شکلی است، در حال تبدیل کردن نویسنده و خواننده به دو دشمن است؛ و من میخواهم دلیلش را به شما بگویم.
با عذرخواهی، سفر ما از لینکدین آغاز میشود. کار در زمینه ارتباطات مدیریتی به این معناست که متاسفانه من زمان زیادی را در آنجا میگذرانم. و اگر از قبل نمیدانستید، لینکدین به مرکز جهانِ نویسندگی با هوش مصنوعی تبدیل شده است. ببینید، برای مدتی، لینکدین اینطور تصمیم گرفت که محتوای تولیدشده با هوش مصنوعی خوب است — یا حداقل بد نیست؛ یا شاید حداقل برای مخاطبانِ دانای کل و سختگیرِ شرکتیاش به اندازه کافی خوب است. چندی پیش، این سایت گزینهای را برای کاربران معرفی کرد تا پیشنویس پستهای خود را بهبود دهند، که در واقع نوعی صیقلدهی و ویرایش نثر توسط هوش مصنوعی بود. اما حجم محتوای تولیدشده یا تقویتشده با هوش مصنوعی در این سایت بهسرعت از کنترل خارج شد؛ بهطوری که طبق مطالعه سال ۲۰۲۶ توسط شرکت تشخیص هوش مصنوعی Pangram، این محتواها ۳۰ درصد از پستهای کوتاه و ۴۱ درصد از پستهای بلند را تشکیل میدادند.
در پاسخ به این وضعیت، این سایت در ماه اوت قابلیتی را معرفی کرد که به کاربران اجازه میدهد هر پستی را که شبیه به زباله هوش مصنوعی به نظر میرسد نشانهگذاری کنند. وقتی کاربران این کار را انجام میدهند، اولویت نمایش پست کاهش مییابد و یادداشتی برای نویسنده فرستاده میشود با این مضمون که مردم آن را مشکوک یافتهاند.
خب، باشد. اما منظور ما از عبارت «به نظر میرسد» چیست؟ به نظر میرسد هر چند ماه یکبار، بهروزرسانی جدیدی درباره جنبههایی از زبان نوشتهشده که چتباتها از آن استفاده (یا سوءاستفاده) میکنند ارائه میشود که نشانهای حتمی و قطعی است. آیا خط تیره بلند (Em Dash) است؟ آیا عبارات کلیشهای است؟ در ماه ژوئیه، نشریه اکونومیست نتایج مطالعهای را منتشر کرد که نوشتههای مدلهای زبانی بزرگ (LLM) را با نوشتههای خود و دیگران مقایسه میکرد و نشانههای واضحی از نثر هوش مصنوعی یافت؛ از جمله آنچه جرج اورول «تعبیرات پرطمطراق» مینامید — یعنی نوشتن با اصطلاحات پیچیده برای باهوش به نظر رسیدن — و همچنین برخی عادتهای نگارشی (ویرگولهای کمتر) و جملات طولانیتر.
این مطالعه همچنین شک و تردیدها را تایید کرد که مدلهای زبانی واقعا ساختارهای «نه X بلکه Y» و «نه تنها… بلکه…» را بیشتر از انسانها استفاده میکنند — یا میکردند. اکونومیست نوشت: «اگر میخواهید نوشته هوش مصنوعی را تشخیص دهید، به دنبال نثری بیروح و پرطمطراق باشید که با کلمات لاتینتبار تزیین شده است — حداقل در حال حاضر. مطالعه ما نشان میدهد با هر بهروزرسانی، نوشته هوش مصنوعی بیشتر به نثر انسانی شباهت پیدا میکند.»
این یک نکته بسیار مهم است، زیرا عناصر واقعی نوشته هوش مصنوعی هرچه باشند، یا هرچقدر هم که تغییر کنند، در نهایت اهمیت کمتری دارند نسبت به این واقعیت که ما اکنون در حال شکار آنها هستیم. نوشتههای تولیدشده با هوش مصنوعی بدون شک یک بلا هستند، و شاید جستجوی مداوم برای یافتن آنها باعث نابودیشان شود. اما به احتمال زیاد، نتیجه این هوشیاری و مراقبت مداوم ما این خواهد بود که لذت خواندن را خراب میکنیم.
دوباره لینکدین را در نظر بگیرید، جایی که مرز میان نوشته انسان و هوش مصنوعی فوقالعاده باریک است. حتی قبل از ظهور مدلهای زبانی بزرگ، بیشتر محتوای لینکدین طوری به نظر میرسید که انگار توسط یک وسیله بیمغز نوشته شده است! اما اکنون وقتی مردم دکمه هشدار تشخیص هوش مصنوعی را میزنند، آیا واقعا هوش مصنوعی را تشخیص میدهند؟ یا اینکه دارند محتوای قدیمی را با روشی جدید میخوانند؟
من گمان میکنم مورد دوم محتملتر است و شواهد خوبی هم برای تایید آن وجود دارد. اخیرا دو پژوهشگر ۲۵ میلیون نظر را در ردیت و هکر نیوز از سال ۲۰۲۳ تا ۲۰۲۶ تحلیل کردند و دریافتند سهم برچسبهای تحقیرآمیز برای خراب کردن نظرات به عنوان هوش مصنوعی — مثلا «زباله هوش مصنوعی» یا «مزخرفات GPT» یا «ترهات یادگیری ماشین» — در این دوره بیش از ۱۰ برابر شده است. کلمه «زباله» (Slop) بهویژه محبوب است و در ۹۴ درصد از تمام اشارههای تحقیرآمیز به هوش مصنوعی استفاده شده است. آنها همچنین متوجه تغییر لحن شدند، زیرا انتقادها از مسخره کردن رفتار بد رباتها به سمت دروازهبانی تند و پرخاشگرانه اجتماعی تغییر یافته است.
اما مشخص شد تقریبا هیچکس نمی دانست چه چیزی را میخواند! پژوهشگران یک آزمون کنترلشده انجام دادند و نظرات انسانی را که متهم به ساخته شدن با هوش مصنوعی شده بودند با نظراتی که متهم نشده بودند مقایسه کردند. سپس آنها به ویژگیهای آماری واقعی نثر نگاه کردند که متن مدل زبانی را از متن انسان تمایز میدهد (بسیار شبیه به آزمون اکونومیست). و جالب اینکه: آن ویژگیهای خاص هوش مصنوعی که متن را از نوشته انسان مجزا میکرد، اصلا پیشبینیکننده اینکه کدام محتوا متهم به هوش مصنوعی بودن میشود نبودند!
به عبارت دیگر، وقتی انسانها به دنبال نشانههایی میگردند که اثبات کنند یک نوشته ساخته هوش مصنوعی است، اشتباه میکنند. تمام این تحقیرهای مرتبط با هوش مصنوعی بهسرعت به نوعی آزمون خلوص و پاکی تبدیل شده و اصلاً ربطی به خود محتوا ندارد. بخشی از تمایل شدید برای برچسب هوش مصنوعی زدن به یک نوشته، برای نشان دادن قدرت تشخیص است — کاری که وقتی فکری دقیق برای بهتر کردن نوشته ندارید انجام میدهید.
این اتهام همچنین راهی آسان برای بیاعتبار کردن سخنی است که فرد به هر دلیلی میخواهد آن را خاموش کند. اما این موضوع همچنین منعکسکننده یک بدگمانی جدید (و تا حدی موجه) است که به زندگی ما نفوذ کرده است: شک و تردید در اینکه آنچه میبینیم واقعی است — یا حداقل از جایی واقعی آمده است.
افرادی مانند من که هر روز به صورت حرفهای مینویسند — چه رمان، خبر، تبلیغات، پیامهای استراتژیک، یا همان «رهبری فکری مدیریتی» که نامی مبهم اما اهمیتی بالا دارد — هر روز این موضوع را حس میکنند. همه تا حدی این را حس میکنند، اما اکنون معمول شده است که کسی درباره نقش هوش مصنوعی در نوشتن پرسش کند. و من این را درک میکنم. گاهی اوقات واقعا «به نظر میرسد» هوش مصنوعی است. به هر حال، مهارتهای لازم برای این کار، از جمله نوشتن با نظم، شفافیت و سطحی از صیقلخوردگی، مهارتهایی هستند که هوش مصنوعی آنها را به بهترین شکل تقلید میکند — که بخش زیادی از آن به این دلیل است که هوش مصنوعی، مانند مارِ دمبهدهان، بر روی همین محتوایی آموزش دیده که همه سالها قبل از ظهور مدلهای زبانی تولید میکردند.
از یک سو، این یک تعریف و تمجید است. اما از سوی دیگر، سناریویی عجیب ایجاد میکند که در آن نوشتهای که ما انجام میدهیم اکنون باید آگاهانه تغییر کند تا انسانیتر به نظر برسد؛ که در واقع به معنای بدتر کردن آن است! شاید یک غلط املایی عمدی؟ یک فکر ناتمام، فقط به خاطر خودش؟ و برای چه — برای فرار از نگاه قضاوتگر خواننده؟ چقدر احمقانه. چقدر دلسردکننده. چقدر عجیب. اما اینها زمانهای غریب هستند؛ عصری که در آن خود را در حال عذرخواهی پیشدستانه یا بدتر از آن، دفن کردن استعداد خود مییابیم. وقتی مردم به دنبال تاثیر هوش مصنوعی بر مشاغل میگردند، آمارها تاثیر نیروی کار را تخمین میزنند اما هرگز احساسی را که بیارزش شدن کار شما ایجاد میکند محاسبه نمیکنند.
اما به همان اندازه که این موضوع درباره نوشتن است، آنچه با آن روبرو هستیم یک بحران نوشتن نیست؛ بلکه یک بحران خواندن است. به لطف تمایل روزافزون خودمان برای کشف نوشتههای غیرواقعی، اکنون در حال تبدیل کردن خواندن به یک تمرین خصمانه هستیم؛ مانند دادستانی که استدلالهای دفاعیه را بررسی میکند. یا شاید دقیقتر، مانند یکی از آن ابزارهای آنلاین بررسی هوش مصنوعی که در حال اسکن و تشخیص الگو است. آیا این رفتار درستی است — تقلید از همان سیستمهای کامپیوتری که ادعا میکنیم از آنها متنفر هستیم؟ من اینطور فکر نمیکنم. اگر بخواهیم هنوز هم میتوانیم به دنبال هوش مصنوعی بگردیم. اما باید این کار را با درک فایده واقعی ایجاد این عادت در برابر هزینه احتمالی آن انجام دهیم.
آن هزینه البته این است که فراموش کنیم چگونه بخوانیم و در این فرآیند، انجام کاری حتی مهمتر را فراموش کنیم: انسان بودن. زیرا به هر حال تا جایی که به من مربوط میشود، خواندن هر چیزی نیازمند کنجکاوی و گشودگی است. این جوهره معاملهای است که هر بار با برداشتن یک کتاب، کلیک روی یک پست یا خواندن اولین جمله از یک مطلب انجام میدهیم. یعنی به یکدیگر در ذهن، زندگی و قلبمان فضای تاثیرپذیری، متقاعد شدن، قانع شدن، الهام گرفتن و غیره را میدهیم. گاهی جواب میدهد و گاهی نه. اما اگر هیچ چیز دیگری هم نباشد، فرصت ایجاد ارتباط وجود داشته است.
بله، جرأت میکنم بگویم حتی در لینکدین! و قصد بزرگنمایی ندارم، اما به نظر میرسد این همان چیزی است که اکنون در معرض خطر است؛ همه به دلیل یک استیصال ساختگی که در خود ایجاد کردهایم تا اثبات کنیم هرگز توسط یک ربات گول نمیخوریم. و البته شاید یک یا دو بار گول نخوریم. اما همانطور که این روشهای تشخیص را به کار میگیریم تا توسط یک کامپیوتر تحت تاثیر قرار نگیریم، ممکن است آسیبپذیری لازم برای تحت تاثیر قرار گرفتن توسط یک انسان را از دست بدهیم.